
Résumé de l'épisode 3
- Objectif : S'affranchir du cloud Zendure en mettant en place une régulation locale et performante sous Home Assistant grâce au principe du « partage d'étendue » (un signal unique gérant à la fois la charge et la décharge des batteries).
- Le choix du YAML : Préféré à l'interface graphique pour sa portabilité, sa lisibilité, et sa capacité à être facilement dupliqué ou versionné.
- Architecture des dossiers : Organisation modulaire autour du fichier maître (configuration.yaml), d'un dossier dédié aux capteurs virtuels (templates/sfp1/) et d'une automatisation cadencée jouant le rôle de cœur de calcul (boucle temporelle).
- Outils clés : Utilisation de curseurs (input_number) pour les réglages en direct, et de capteurs logiciels basés sur Jinja2 pour déterminer en temps réel les calculs du régulateur.
___
Épisode 3 : Piloter son SolarFlow Zendure en local sous Home Assistant : Guide de l'architecture YAML
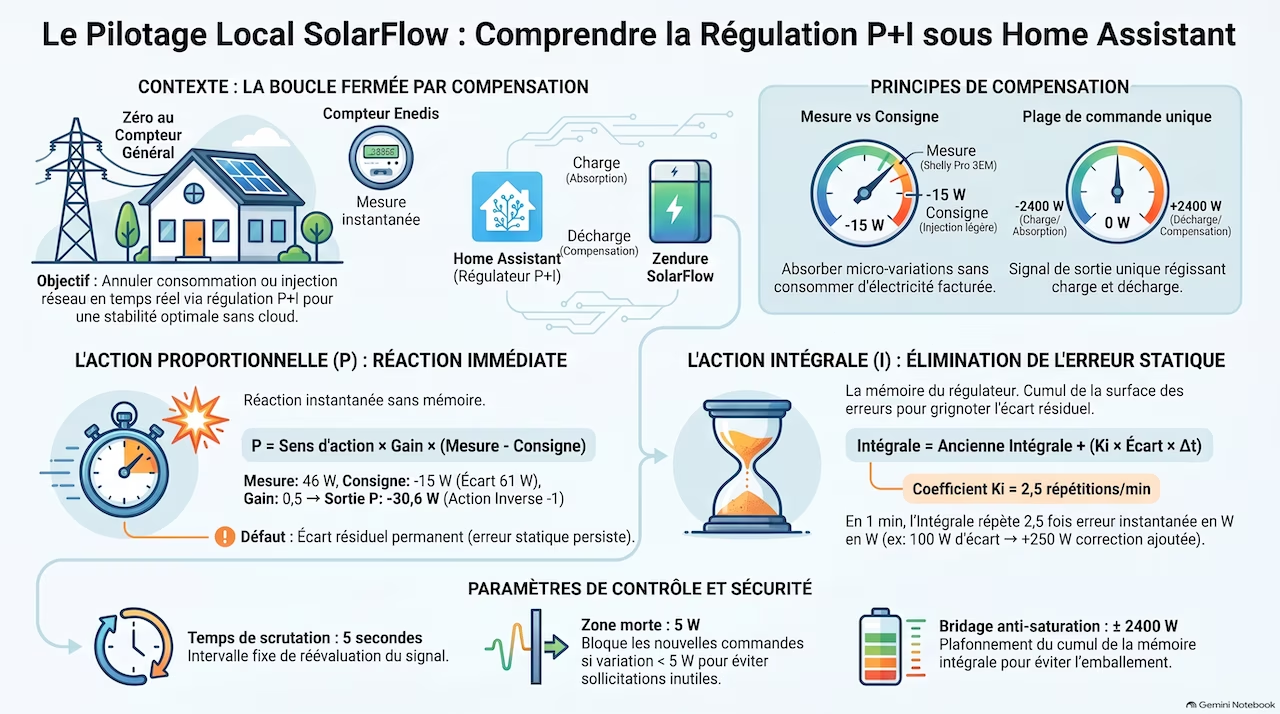
Affranchir ses équipements du cloud constructeur tout en conservant une précision chirurgicale est un défi passionnant. Après avoir posé les bases théoriques de la régulation PID et du « partage d'étendue » (où un unique signal de commande gère à la fois la charge et la décharge de la batterie selon son signe), cet épisode 3 s'attaque à la mise en place de l'environnement local en YAML sous Home Assistant.
🤔 Comment structurer ses fichiers, pourquoi abandonner l'interface graphique au profit du YAML, et comment organiser ses dossiers de manière modulaire ? Faisons le point pas à pas.
1. Pourquoi privilégier le YAML à l'interface graphique ?
Dans Home Assistant, il est très simple de créer des entrées (helpers) ou des automatisations via des clics sur l'interface graphique. Cependant, pour un projet d'optimisation énergétique un tant soit peu avancé, cette approche montre rapidement ses limites :
- Des données cachées : Les configurations créées par l'interface sont stockées dans des bases de données internes opaques, impossibles à modifier en masse ou à auditer.
- L'impossibilité de dupliquer : Si vous souhaitez étendre votre installation (sfp1) à un second ou troisième onduleur (sfp2, sfp3), vous devrez tout recréer à la main, clic par clic, avec un risque élevé d'erreurs de nommage.
- L'absence de suivi de version : Impossible de suivre l'historique des modifications ou de partager facilement du code propre avec la communauté.
En choisissant le YAML (un langage de description de données textuel, structuré par l'indentation), vous reprenez le contrôle total : vos fichiers sont portables, lisibles, "versionnables" et facilement duplicables.
2. Le chef d'orchestre : configuration.yaml
Le fichier configuration.yaml est la pierre angulaire de votre installation. Il remplit trois rôles majeurs pour notre régulateur :
- Chargement de la base : Il active la configuration par défaut (default_config:).
- Optimisation du stockage (recorder) : Il exclut de la mémoire les variables à très forte fréquence de mise à jour (comme les calculs internes du régulateur ou l'état de la batterie) pour éviter de saturer la mémoire et le disque de sauvegarde.
- Déclaration des inclusions (!include) : C'est lui qui indique à Home Assistant où aller piocher nos fichiers d'automatisations spécifiques (automations_sfp1.yaml) et nos dossiers de capteurs virtuels. Sans lui, le système ignorerait totalement notre architecture modulaire spécifique.
3. Une architecture modulaire et pensée pour l'évolutivité.
Pour éviter le piège du « fichier monolithique géant » où tout est mélangé, l'architecture du projet s'organise autour de dossiers dédiés :
- Le dossier des templates (templates/) : Il centralise l'ensemble de nos capteurs virtuels calculés mathématiquement. Pour notre projet, nous y avons créé un sous-dossier dédié : sfp1/ (pour SolarFlow Phase 1).
- Le fichier de simulation et de calculs (sfp1_simulation.yaml) : Placé à l'intérieur du sous-dossier sfp1, il fait office de calculateur intelligent. Il évalue en temps réel l'écart entre la mesure du compteur Enedis et la consigne souhaitée, en s'appuyant sur des filtres Jinja2 (comme | float(0) et | round(1)).
💡 Pourquoi cette structure en sous-dossier ?
Le jour où vous installerez un second système SolarFlow dans un second HEMS, il vous suffira de dupliquer le dossier sfp1 en un dossier sfp2, d'adapter les identifiants d'entités, et votre architecture sera immédiatement opérationnelle !
4. Le cœur actif : L'automatisation cadencée
Le fichier d'automatisation spécifique (automations_sfp1.yaml) fait office de métronome.
- Il utilise un déclencheur temporel (time pattern) configuré par exemple sur une base de 3 secondes pour exécuter la boucle de calcul.
- Un système de condition vérifie si le régulateur est en mode Automatique ou Manuel.
En mode automatique, la boucle tourne en arrière-plan pour ajuster continuellement la puissance de charge ou de décharge des batteries Zendure.
En mode manuel, l'utilisateur garde la main via un curseur (input_number qui règle le S0), bien que cette approche demande de la rigueur face aux fluctuations du réseau.
En résumé
Structurer son projet SolarFlow en local sous Home Assistant demande un peu de rigueur au démarrage, mais c'est la clé d'un système stable, performant et évolutif. En séparant clairement les entités de réglage, les capteurs virtuels et les boucles d'automatisation dans des fichiers YAML indépendants, vous posez des fondations solides pour piloter votre énergie en toute autonomie.
Rendez-vous dans le prochain épisode pour découvrir comment générer et configurer l'algorithme central sans effort !
Visualisez la vidéo correspondante...